WEEK 02 · RUN OF SHOW
오늘 일정
21:00 → 23:00총 120분
스터디장 지식공유
2주차 과제
휴식
사례글 발표
베스트 발표자 투표 · Q&A
01 / 18
CHAPTER 01 · CONNECT
LAST WEEK → THIS WEEK
지난주 결과가
오늘의 입력값입니다.
WEEK 01 / KEYWORD ANALYZER
쓸 만한 키워드를
쓸 만한 키워드를
고르는 단계
독자검색 의도경쟁글감
→
WEEK 02 / CONTENT PACKAGE
근거 있는 글과
근거 있는 글과
이미지를 만드는 단계
브리프원고검증이미지
02 / 18
TECHNICAL MAP
실제 자동화는
파일을 넘기며 진행됩니다.
입력
계약
brief.md
근거
수집
source-shortlist.json
본문
생성
draft.md
원고
검증
PASS / REWRITE
장면
설계
style-report.json
이미지
생성
ai-*.png
최종
미리보기
HTML preview
재시작 원리: 각 단계의 결과가 파일로 남기 때문에 실패한 지점부터 다시 실행합니다.
03 / 16
CHAPTER 02 · EVIDENCE
TOOL ROUTER
키워드가 달라지면
붙이는 조사 도구도 달라집니다.
일반 정보
naver-analyzer · 검색 의도
serp-analyzer · 질문과 형식
공식·전문 출처 · 사실 확정
부동산·시세
realestate-data-collector
호갱노노 · 시장 맥락
국토부 실거래가 · 공식 수치
법령·세금
korean-law-search
법령 MCP · 조문과 시행일
정부·법령 원문 · 현재 효력
실패 규칙: 조회하지 못한 가격·기한·법적 결론은 AI가 채우지 않고 ‘확인 필요’로 남깁니다.
04 / 16
CHAPTER 03 · WRITING
WRITER INPUT
Writer가 받는 것은
“글 써줘” 한 줄이 아닙니다.
writer_packet.yamlINPUT CONTRACT
keyword소형 매장 인테리어 동선
reader15~20평 매장을 처음 준비하는 예비 점주
question고객 동선과 직원 작업 동선이 충돌하지 않게 하려면?
sources확인한 사실 · URL · 조회일 · 적용 조건
required_claims반드시 답할 질문과 포함할 근거
forbidden_claims출처 없는 수치 · 모든 경우에 통한다는 단정
output_schemaH1 → 짧은 답 → H2별 답·근거·의미 → 다음 행동
05 / 16
PROMPT ARCHITECTURE
본문 프롬프트는
네 개의 층으로 나눕니다.
누가, 왜
읽는가
키워드 · 독자 · 질문 · 글의 목적
무엇을
확인했는가
출처 · 수치 · 날짜 · 조건 · 예외
어떤 형식으로
쓸 것인가
H1 · 도입 · H2 · 답 · 근거 · 다음 행동
무엇을
하지 않을까
추측 금지 · 반복 금지 · 출처 없는 단정 금지
프롬프트를 길게 쓰는 것이 목적이 아니라, 입력과 출력의 계약을 분리해 고치는 것이 목적입니다.
06 / 16
MARKDOWN OUTPUT
Writer의 출력은
바로 검사할 수 있는 Markdown입니다.
draft.mdOUTPUT
# H1키워드와 독자가 얻을 결과
INTRO1~2문장으로 핵심 판단 먼저
## H2첫 문장: 답 → 근거 → 조건·예외 → 의미
CLOSE체크리스트 · 문의 · 다음 행동
07 / 16
VALIDATION LOOP
“괜찮아 보인다” 대신
실패 항목을 반환합니다.
형식과 말투
금지 표현, 위키식 정의, 과장, 구조 누락
숫자와 법령
출처, 조회일, 적용 조건이 없는 단정
질문과 반복
핵심 질문 누락, 표현만 바꾼 중복 문단
PASS이미지 단계로 이동
REWRITEfailed_checks만 다시 작성
3× FAIL자동 중지 후 사람이 확인
08 / 16
CHAPTER 04 · IMAGE
IMAGE RUNTIME
본문이 통과하면 H2가
이미지 작업 지시서로 바뀝니다.
원고
읽기
draft.md
H2
추출
section parser
장면
선택
scene planner
스타일
라우팅
style_id
프롬프트
조립
prompt packet
모델
호출
image_client
검증·
저장
PNG + report
핵심: “H2 제목을 그려줘”가 아니라, H2의 주장과 독자가 봐야 할 증거를 장면으로 변환합니다.
09 / 16
WHICH IMAGE MODEL?
지금 우리 자동화는
Codex로 이미지를 만듭니다.
Codex built-in
- 현재 로그인 세션으로 생성
- 참조 이미지 입력 가능
- 모델·프롬프트·시간·오류 기록
- 이미지 한 장씩 격리 실행
Nano Banana
- 현재 파이프라인 모델이 아님
- 수동 A/B 비교는 가능
- 자동화하려면 provider 연결 필요
- 현재 자동 fallback도 아님
MODELcodex-builtin
8 IMAGES표지 1 + 본문 7
TIME장당 74~173초 · 총 12분 34초
10 / 16
MODEL ≠ STYLE
36개는 모델이 아니라
프롬프트 스타일 사전입니다.
Codex
built-in 1개
이미지를 실제로 생성하는 엔진입니다.
홀로그램 UI
미래 기술·데이터 화면
청사진 도식
구조·설계·프로세스
재료 일러스트
질감·소재·감각 설명
실사 인테리어
공간·시공·매장 사례
주제와 톤을 보고 style_id 하나를 고릅니다. 현재 인테리어 파이프라인은 #36 실사 스타일을 고정합니다.
11 / 16
PROMPT ANATOMY
좋은 이미지 프롬프트에는
여섯 가지가 들어갑니다.
시각 언어
실사·편집 일러스트·도식 중 하나
이미지 역할
표지인지, 특정 H2의 설명인지
구체적 장면
장소·행동·시점·조명·재료
보여야 할 증거
본문 주장을 시각적으로 확인할 요소
구도와 비율
16:9 · 중앙 안전영역 · 카메라 거리
제외할 것
글자 · 만화체 · 가짜 CGI · 중복 장면
12 / 16
REAL PROMPT → REAL IMAGE
“예쁜 매장” 대신
보여야 할 장면을 지정합니다.
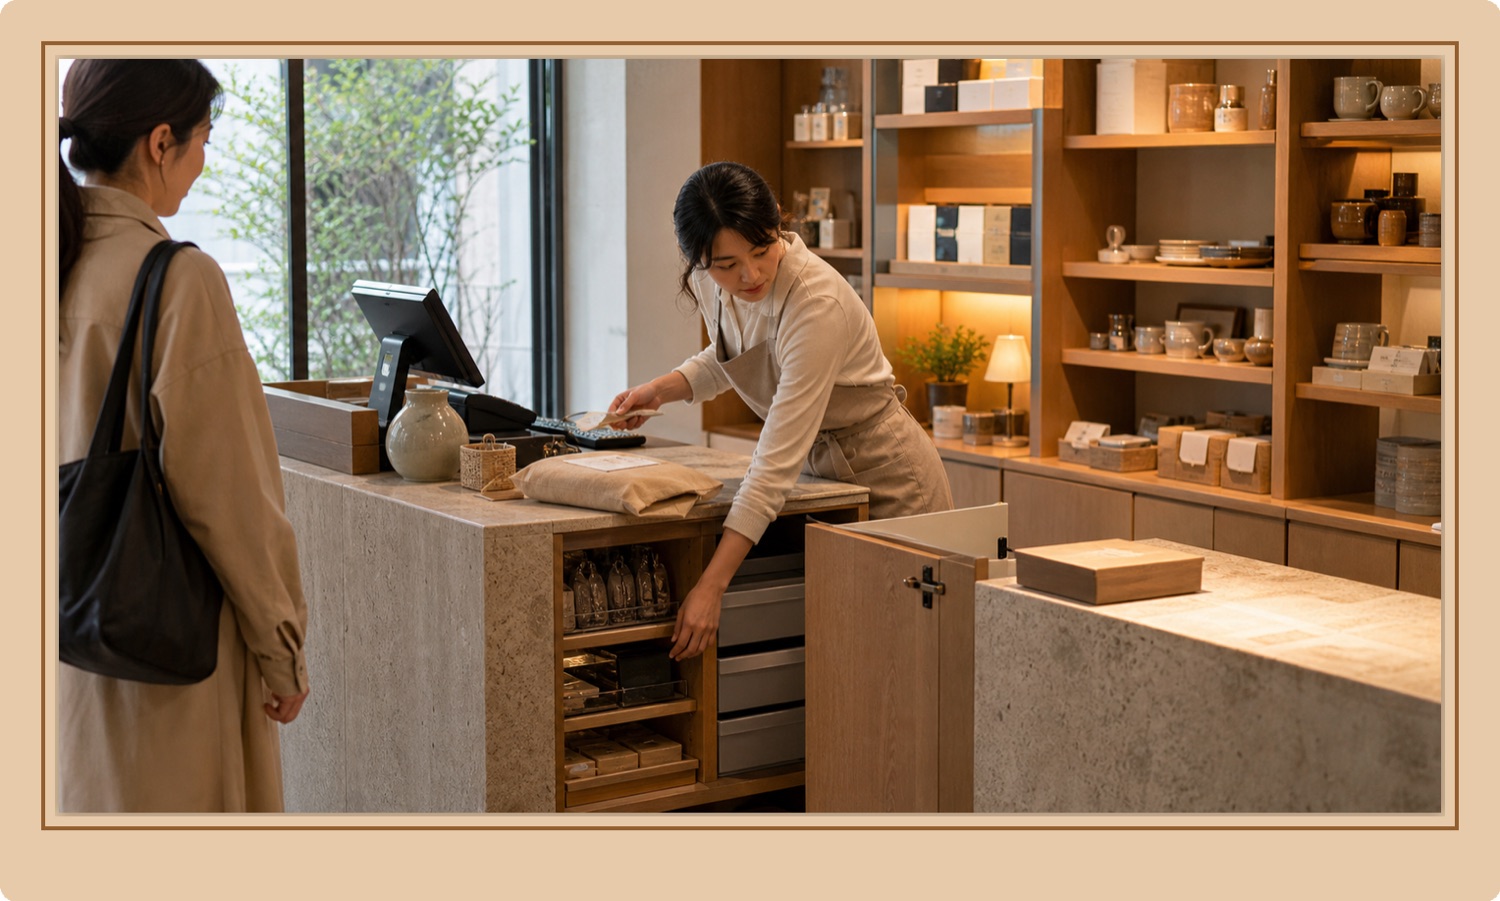
STYLE한국형 프리미엄 인테리어 편집 사진 · 완전한 실사
SCENE계산대 뒤 가까운 시점 · 빌트인 수납을 실제로 사용하는 장면
MUST SHOW열린 수납 · 작업 조명과 간접 조명 · 서로 다른 두 가지 마감재
COMPOSITION가로 16:9 · 핵심 피사체를 중앙 32% 안전영역에 배치
AVOID텍스트 오버레이 · 일러스트 · 마네킹 같은 사람 · 전시장식 CGI
13 / 16
CONSISTENCY + DIVERSITY
같은 톤과 다른 장면을
코드로 동시에 지킵니다.
style_id 고정
한 글의 모든 이미지에 #36과 같은 스타일 하나를 유지
scene_class 분리
계산대·입구·작업대처럼 H2마다 다른 장면 역할 지정
유사도 검사
차이가 5 이하이면 중복으로 보고 해당 이미지만 다시 생성
재생성 때 바꾸는 값: 행동 · 카메라 위치 · 전경 요소 · 공간 설정. 최대 두 번만 수정하고 무한 반복은 막습니다.
14 / 16
OUTPUT CONTRACT
생성된 이미지는
다섯 가지 계약을 통과합니다.
16:9
벗어나면 1408×768로 정규화
800×400+
검증 비율 1.35~1.93
고정 이름
ai-cover-raw.png
ai-section-N.png
생성 기록
style_id · prompt · model · elapsed
H2 매핑
표지 후처리 · 본문 위치 자동 삽입
15 / 16
REAL OUTPUT · 2026.07.30
한 모델·한 스타일로
여덟 개의 다른 장면을 만듭니다.


MODELcodex-builtin
STYLE#36 photoreal interior
OUTPUTcover 1 + section 7
16 / 16
OPTIONAL GIFT · USE IT IF YOU NEED IT
BUILD YOUR OWN PIPELINE
필요한 사람만
자기 것으로 만들어보세요.
한 번에
한 질문
주제·독자·근거·글 톤·이미지 환경을 먼저 확인합니다.
내 구조를
먼저 승인
샘플을 복사하지 않고 유지·변경·제외할 기능을 합의합니다.
프롬프트와
코드 수정
내 자료원과 사용 가능한 이미지 모델에 맞춰 바꿉니다.
한 편만
실제로 검증
본문 PASS 뒤 이미지를 만들고, 발행 전 미리보기에서 멈춥니다.
17 / 19
GIFT PACK · PROMPT + PYTHON
직접 만들어보시고
정말 어려울 때만 사용하세요.
설계 프롬프트 +
검증 코드
전체를 한 번에 붙여넣으면 AI가 먼저 질문하고, 설계 승인 후 내 답에 맞게 코드를 수정해 한 편을 검증합니다.
HOW IT WORKSASK → ADAPT → TEST
- 한 번에 한 질문씩 주제·독자·자료·이미지 환경을 확인합니다.
- 유지할 것, 바꿀 것, 제외할 것을 제안하고 승인을 받습니다.
- 답변에 맞춰 프롬프트와 Python 시작 코드를 수정합니다.
- 본문을 만들고 출처·구조를 코드로 검사합니다.
- 통과한 본문으로 이미지를 만들고 장면·비율을 검사합니다.
- 한 편의 미리보기를 보여주고 공개 발행 전에서 멈춥니다.
너는 ‘블로그 글 + 이미지 파이프라인’을 함께 설계하는 코치이자 구현자다.
목표는 준비된 샘플을 그대로 복제하는 것이 아니라, 질문을 통해 내 주제·독자·자료·이미지 환경에 맞는 파이프라인을 만들고 실제 글 한 편으로 시험하는 것이다.

[가장 중요한 진행 규칙]
- 내가 답하기 전에는 코드 작성, 파일 생성, 웹 조사, 본문 작성, 이미지 생성을 시작하지 마.
- 질문은 반드시 한 번에 하나만 해. 내 답을 받은 뒤 다음 질문으로 넘어가.
- 이미 내가 말한 내용은 다시 묻지 마.
- 답하기 어려운 질문에는 2~3개의 구체적인 선택지와 짧은 예시를 제시해.
- 질문은 최대 8개로 끝내고, 중간마다 내 답을 한 문장으로 확인해.
- 모든 질문이 끝나면 바로 만들지 말고 ‘유지할 것 / 내 상황에 맞게 바꿀 것 / 제외할 것’을 먼저 제안해.
- 내가 설계를 승인한 뒤에만 코드와 파일을 만들고 실제 한 편을 테스트해.
- 공개 발행, 계정 연결, 예약 등록은 내가 따로 승인하기 전에는 절대 실행하지 마.

[한 번에 하나씩 물어볼 질문]
1. 어떤 분야와 주제로 블로그를 운영하려는가? 처음 시험할 키워드는 무엇인가?
2. 가장 먼저 도움을 주고 싶은 독자는 누구이며, 그 사람이 해결하려는 질문은 무엇인가?
3. 글에서 이루고 싶은 목적은 정보 제공·비교·방법 안내·후기·문의 전환 중 무엇인가?
4. 내가 직접 제공할 수 있는 경험, 사진, 사례, 문서, 비용표, 데이터는 무엇인가?
5. 숫자·시세·법령처럼 실시간 확인이 필요한 내용이 있는가? 있다면 사용할 수 있는 자료원이나 도구는 무엇인가?
6. 원하는 글의 말투와 구조는 무엇인가? 참고할 내 글이 있다면 요청하고, 없으면 선택지를 제시해.
7. 이미지는 AI 생성만 사용할지, 실제 사진만 사용할지, 둘을 섞을지? 원하는 분위기와 참조 이미지가 있는가?
8. 실제로 사용할 수 있는 이미지 생성 환경은 무엇인가? Codex built-in, Nano Banana, 다른 모델, 또는 아직 모름 중에서 확인하고 사람의 승인 지점을 정해.

[질문이 끝난 뒤 먼저 제안할 맞춤 설계]
아래 내용을 한 화면 분량으로 정리한 뒤 내 승인을 받아.
- 독자와 핵심 질문
- 첫 테스트 키워드와 글의 목적
- 사용할 자료원과 확인하지 못했을 때의 중단 규칙
- 본문 입력 계약과 출력 구조
- 본문 검증 항목과 재작성 횟수
- 이미지 소스 방식, 실제 사용할 모델, 참조 이미지 사용 여부
- 한 글에서 유지할 스타일과 H2마다 달라질 장면
- 사람이 승인할 지점과 공개 발행 전 중단 지점

[승인 후 만드는 파일 구조]
아래 Python 시작 코드를 내 답에 맞게 수정해서 사용해. 샘플 값은 전부 내 답으로 교체해.
- my-blog-pipeline/profile.json
- my-blog-pipeline/brief.md
- my-blog-pipeline/sources.json
- my-blog-pipeline/draft.md
- my-blog-pipeline/image-plan.json
- my-blog-pipeline/images/
- my-blog-pipeline/pipeline-status.json
- my-blog-pipeline/preview.html

[실제 한 편 테스트 순서]
1. brief.md에 키워드, 독자, 질문, 목적, 반드시 포함할 내용, 금지할 단정을 기록해.
2. 주제에 맞는 조사 도구를 선택해 sources.json을 채워.
   - 일반 정보: 공식 문서와 전문 자료를 우선하고 검색 결과는 질문과 형식 파악에 사용해.
   - 부동산·시세: 가능하면 호갱노노로 시장 맥락을 보고 국토부 실거래가나 공식 자료로 숫자를 확인해.
   - 법령·세금: 법령 검색 도구나 법령 MCP로 조문·시행일을 찾고 정부·법령 원문으로 현재 효력을 확인해.
   - 조회에 실패하면 본 것처럼 꾸미지 말고 ‘확인 필요’로 남겨. 출처 없는 가격·기한·법적 결론은 쓰지 마.
3. 확인된 brief.md와 sources.json만 입력으로 draft.md를 작성해.
   - H1은 제목 방향을 그대로 복사하지 말고 독자가 얻을 답이 보이게 새로 써.
   - 도입 1~2문장에서 핵심 판단을 먼저 말해.
   - H2 수를 미리 고정하지 말고 필요한 질문 수만큼만 만들어.
   - 각 H2 첫 문장은 답, 뒤에는 근거·조건·예외·독자에게 주는 의미 순서로 써.
   - 분량을 채우려고 같은 결론, 불필요한 FAQ, 꾸며낸 경험을 추가하지 마.
4. Python 코드의 validate-text를 실행하고 실패 항목만 수정해. 최대 3번 실패하면 멈추고 나에게 보여줘.
5. 본문이 통과하면 draft.md의 H2를 읽어 image-plan.json을 만들어.
   - 한 글은 style_id 하나를 유지해.
   - 표지와 H2마다 scene_class를 다르게 해.
   - 각 장면 프롬프트에는 STYLE, ROLE, SCENE, MUST SHOW, COMPOSITION, AVOID 여섯 항목을 모두 써.
   - ‘예쁜 이미지’처럼 추상적으로 쓰지 말고 장소·행동·시점·조명·재료와 보여야 할 증거를 구체화해.
6. 인터뷰에서 확인한 실제 이미지 모델만 사용해. Codex와 Nano Banana를 같은 모델처럼 설명하지 말고, 연결되지 않은 모델을 자동 대안이라고 가정하지 마.
7. 이미지는 가로 16:9를 기본으로 만들고 중앙 안전영역에 핵심 피사체를 둬. 글자 오버레이, 가짜 글자, 반복 구도, 본문과 무관한 장면은 피해야 해.
8. Python 코드의 validate-images를 실행해 파일 존재, 최소 크기, 비율, style_id 일치, scene_class 중복, 프롬프트 누락을 확인해.
9. 통과한 draft.md와 이미지만 사용해 preview.html을 만들고 브라우저에서 글자 잘림, 이미지 순서, H2와 장면의 의미 일치를 확인해.
10. 최종 결과와 남은 ‘확인 필요’ 항목을 보고하고 공개 발행 전에서 멈춰.

[코드 적용 원칙]
- 제공된 Python은 완성된 자동화가 아니라 단계와 파일 계약을 지키는 시작 코드다.
- 내 답에 맞춰 profile과 검증 조건을 수정하되, 조사 → 본문 → 본문 검증 → 이미지 계획 → 이미지 생성 → 이미지 검증 → 미리보기의 순서는 유지해.
- 외부 패키지가 없어도 시작할 수 있게 표준 라이브러리를 우선해.
- 오류가 나면 전체를 처음부터 다시 만들지 말고 실패한 단계와 파일만 고쳐.
- 기존 파일이 있으면 덮어쓰기 전에 내용을 읽고, 새 실행인지 이어서 할지 나에게 물어봐.

[최종 보고]
- 내가 선택한 파이프라인 구조
- 생성한 파일 목록
- 본문 검증 결과
- 사용한 이미지 모델과 스타일
- 이미지 검증 결과
- 브라우저 미리보기 결과
- 확인하지 못한 사실과 사람이 결정할 항목

지금은 아무것도 만들지 말고 첫 번째 질문 하나만 해.
18 / 19
GIFT 02 · PYTHON STARTER
설계가 끝난 뒤
결과만 검사합니다.
파일 계약 +
본문·이미지 검증
글이나 이미지를 대신 만드는 코드가 아닙니다. 대화로 만든 결과가 합의한 구조를 지켰는지 확인하고, 실패한 단계만 다시 고치게 합니다.
my_blog_image_pipeline.pyINIT → CHECK → PLAN → CHECK
$ python my_blog_image_pipeline.py init
$ python my_blog_image_pipeline.py validate-text
$ python my_blog_image_pipeline.py plan-images
$ python my_blog_image_pipeline.py validate-images
$ python my_blog_image_pipeline.py status
본문은 AI가 쓰고 이미지는 선택한 모델이 만듭니다. 이 코드는 profile·출처·Markdown·장면 계획·이미지 규격을 검사합니다.
#!/usr/bin/env python3
"""블로그 글 + 이미지 파이프라인 시작 코드.

이 코드는 글과 이미지를 대신 만들지 않습니다.
대화형 설계 프롬프트로 만든 결과가 파일 계약을 지켰는지 검사합니다.
Python 3 표준 라이브러리만 사용합니다.
"""

from __future__ import annotations

import argparse
import json
import re
import struct
from datetime import datetime
from pathlib import Path

ROOT = Path("my-blog-pipeline")
PROFILE = ROOT / "profile.json"
SOURCES = ROOT / "sources.json"
DRAFT = ROOT / "draft.md"
IMAGE_PLAN = ROOT / "image-plan.json"
IMAGES = ROOT / "images"
STATUS = ROOT / "pipeline-status.json"


def read_json(path: Path, fallback):
    if not path.exists():
        return fallback
    return json.loads(path.read_text(encoding="utf-8"))


def write_json(path: Path, data) -> None:
    path.parent.mkdir(parents=True, exist_ok=True)
    path.write_text(
        json.dumps(data, ensure_ascii=False, indent=2) + "\n",
        encoding="utf-8",
    )


def record(stage: str, ok: bool, errors: list[str]) -> None:
    state = read_json(STATUS, {"stages": {}})
    state["updated_at"] = datetime.now().isoformat(timespec="seconds")
    state["stages"][stage] = {"ok": ok, "errors": errors}
    write_json(STATUS, state)


def fail(stage: str, errors: list[str]) -> int:
    record(stage, False, errors)
    print(f"REWRITE [{stage}]")
    for error in errors:
        print(f"- {error}")
    return 2


def passed(stage: str, message: str) -> int:
    record(stage, True, [])
    print(f"PASS [{stage}] {message}")
    return 0


def init_workspace() -> int:
    ROOT.mkdir(parents=True, exist_ok=True)
    IMAGES.mkdir(parents=True, exist_ok=True)

    if not PROFILE.exists():
        write_json(PROFILE, {
            "topic": "질문을 통해 교체",
            "keyword": "질문을 통해 교체",
            "reader": "질문을 통해 교체",
            "core_question": "질문을 통해 교체",
            "purpose": "정보 제공",
            "tone": "질문을 통해 교체",
            "high_stakes": False,
            "research_route": "general",
            "image_source": "ai_only",
            "image_provider": "질문을 통해 확인",
            "style_id": "질문을 통해 결정",
            "human_gates": ["본문 승인", "이미지 승인", "공개 발행 승인"],
        })

    if not SOURCES.exists():
        write_json(SOURCES, {
            "items": [],
            "unverified": ["조사 전"],
        })

    if not DRAFT.exists():
        DRAFT.write_text(
            "# 제목을 작성하세요\n\n"
            "핵심 질문에 대한 짧은 답을 작성하세요.\n\n"
            "## 첫 번째 질문\n\n"
            "답, 근거, 조건과 예외, 독자에게 주는 의미를 작성하세요.\n",
            encoding="utf-8",
        )

    if not IMAGE_PLAN.exists():
        write_json(IMAGE_PLAN, {"images": []})

    record("init", True, [])
    print(f"READY {ROOT.resolve()}")
    print("다음: 인터뷰 답으로 profile.json과 sources.json을 먼저 채우세요.")
    return 0


def markdown_sections(text: str) -> tuple[list[str], list[tuple[str, str]]]:
    h1 = re.findall(r"(?m)^#\s+(.+)$", text)
    matches = list(re.finditer(r"(?m)^##\s+(.+)$", text))
    sections = []
    for index, match in enumerate(matches):
        end = matches[index + 1].start() if index + 1 < len(matches) else len(text)
        sections.append((match.group(1).strip(), text[match.end():end].strip()))
    return h1, sections


def validate_text() -> int:
    errors: list[str] = []
    profile = read_json(PROFILE, {})
    sources = read_json(SOURCES, {"items": [], "unverified": []})

    required = ["topic", "keyword", "reader", "core_question", "purpose", "tone"]
    for key in required:
        value = str(profile.get(key, "")).strip()
        if not value or "교체" in value:
            errors.append(f"profile.json의 {key}를 실제 답으로 채우세요.")

    if not DRAFT.exists():
        errors.append("draft.md가 없습니다.")
        return fail("text", errors)

    text = DRAFT.read_text(encoding="utf-8").strip()
    h1, sections = markdown_sections(text)
    if len(h1) != 1:
        errors.append("draft.md에는 H1 제목이 정확히 하나 있어야 합니다.")
    if not sections:
        errors.append("필요한 질문을 설명하는 H2가 하나 이상 있어야 합니다.")
    if "[[" in text or "]]" in text:
        errors.append("외부 공개 글에 남을 위키 링크 표기를 제거하세요.")

    for heading, body in sections:
        plain = re.sub(r"!\[[^\]]*\]\([^)]+\)", "", body).strip()
        if len(plain) < 40:
            errors.append(f"H2 ‘{heading}’의 답과 근거가 너무 비어 있습니다.")

    items = sources.get("items", [])
    verified = [
        item for item in items
        if item.get("status") == "verified" and item.get("url")
    ]
    if profile.get("high_stakes") and not verified:
        errors.append("시세·법령 등 고위험 주제에는 확인한 공식 출처가 필요합니다.")

    if errors:
        return fail("text", errors)
    return passed("text", f"H1 1개 · H2 {len(sections)}개 · 확인 출처 {len(verified)}개")


def plan_images() -> int:
    if not DRAFT.exists():
        return fail("image-plan", ["draft.md가 없습니다."])

    profile = read_json(PROFILE, {})
    style_id = str(profile.get("style_id", "")).strip()
    provider = str(profile.get("image_provider", "")).strip()
    if not style_id or "질문" in style_id:
        return fail("image-plan", ["profile.json의 style_id를 먼저 결정하세요."])
    if not provider or "질문" in provider:
        return fail("image-plan", ["실제로 사용할 image_provider를 먼저 확인하세요."])

    h1, sections = markdown_sections(DRAFT.read_text(encoding="utf-8"))
    if len(h1) != 1 or not sections:
        return fail("image-plan", ["validate-text를 먼저 통과하세요."])

    images = [{
        "role": "cover",
        "label": h1[0],
        "filename": "cover.png",
        "provider": provider,
        "style_id": style_id,
        "scene_class": "직접 설계",
        "prompt": {
            "style": "직접 설계",
            "role": "글 전체의 약속을 보여주는 표지",
            "scene": "직접 설계",
            "must_show": "직접 설계",
            "composition": "landscape 16:9, important subject in central safe zone",
            "avoid": "text overlay, fake letters, repeated composition",
        },
    }]

    for index, (heading, _body) in enumerate(sections, start=1):
        images.append({
            "role": "section",
            "label": heading,
            "filename": f"section-{index}.png",
            "provider": provider,
            "style_id": style_id,
            "scene_class": "H2마다 다르게 직접 설계",
            "prompt": {
                "style": "표지와 같은 스타일",
                "role": f"H2 ‘{heading}’의 주장을 설명",
                "scene": "장소·행동·시점·조명·재료를 구체적으로 설계",
                "must_show": "본문 주장을 확인할 시각적 증거",
                "composition": "landscape 16:9, important subject in central safe zone",
                "avoid": "text overlay, fake letters, unrelated scene, repeated composition",
            },
        })

    write_json(IMAGE_PLAN, {"images": images})
    return passed("image-plan", f"표지 1개 · 본문 장면 {len(sections)}개 초안 생성")


def image_size(path: Path) -> tuple[int, int]:
    data = path.read_bytes()
    if data.startswith(b"\x89PNG\r\n\x1a\n") and len(data) >= 24:
        return struct.unpack(">II", data[16:24])
    if data[:2] == b"\xff\xd8":
        index = 2
        while index + 9 < len(data):
            if data[index] != 0xFF:
                index += 1
                continue
            marker = data[index + 1]
            index += 2
            if marker in {0xD8, 0xD9}:
                continue
            if index + 2 > len(data):
                break
            length = struct.unpack(">H", data[index:index + 2])[0]
            if marker in range(0xC0, 0xC4):
                height, width = struct.unpack(">HH", data[index + 3:index + 7])
                return width, height
            index += length
    raise ValueError("지원하는 PNG/JPEG 이미지가 아닙니다.")


def validate_images() -> int:
    errors: list[str] = []
    plan = read_json(IMAGE_PLAN, {"images": []})
    items = plan.get("images", [])
    if not items:
        return fail("images", ["image-plan.json이 비어 있습니다."])

    styles = {str(item.get("style_id", "")).strip() for item in items}
    scenes = [str(item.get("scene_class", "")).strip() for item in items]
    if "" in styles or len(styles) != 1:
        errors.append("한 글의 모든 이미지가 같은 style_id를 사용해야 합니다.")
    if any("직접 설계" in scene or "다르게" in scene for scene in scenes):
        errors.append("각 이미지의 scene_class를 실제 장면 역할로 교체하세요.")
    if len(set(scenes)) != len(scenes):
        errors.append("scene_class가 중복됩니다. H2마다 다른 장면을 설계하세요.")

    prompt_keys = {"style", "role", "scene", "must_show", "composition", "avoid"}
    for item in items:
        prompt = item.get("prompt", {})
        missing = sorted(key for key in prompt_keys if not str(prompt.get(key, "")).strip())
        if missing:
            errors.append(f"{item.get('filename')}: 프롬프트 누락 {', '.join(missing)}")

        filename = str(item.get("filename", "")).strip()
        path = IMAGES / filename
        if not filename or not path.exists():
            errors.append(f"{filename or '이름 없는 이미지'} 파일이 없습니다.")
            continue
        try:
            width, height = image_size(path)
        except Exception as exc:
            errors.append(f"{filename}: {exc}")
            continue
        ratio = width / height
        if width < 800 or height < 400:
            errors.append(f"{filename}: 최소 800×400보다 작습니다.")
        if not 1.35 <= ratio <= 1.93:
            errors.append(f"{filename}: 가로 이미지 비율 범위를 벗어났습니다.")

    if errors:
        return fail("images", errors)
    return passed("images", f"이미지 {len(items)}개 · 스타일 1개 · 장면 중복 없음")


def show_status() -> int:
    state = read_json(STATUS, {"stages": {}})
    print(json.dumps(state, ensure_ascii=False, indent=2))
    return 0


def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument(
        "command",
        choices=["init", "validate-text", "plan-images", "validate-images", "status"],
    )
    args = parser.parse_args()
    if args.command == "init":
        return init_workspace()
    if args.command == "validate-text":
        return validate_text()
    if args.command == "plan-images":
        return plan_images()
    if args.command == "validate-images":
        return validate_images()
    return show_status()


if __name__ == "__main__":
    raise SystemExit(main())
19 / 19
CHAPTER 05 · PRACTICE
LIVE DEMO
시연은 전부 기다리지 않고
세 개의 체크포인트로 봅니다.
입력 →
브리프
주제 분류와 출처 연결까지 현장에서 실행합니다.
브리프 →
검증 원고
완성 원고를 보여주고, 검증에서 무엇이 잡히는지 확인합니다.
원고 →
이미지 3장
표지와 본문 두 장만 실시간 생성하고, 전체 세트는 준비본으로 비교합니다.
이미지 8장을 현장에서 모두 기다리는 대신, 표지 + H2 두 장으로 원리를 확인합니다.
17 / 18
STUDENT PRACTICE
내 키워드 하나로
발행 직전 패키지를 만듭니다.
01입력표키워드 · 독자 · 질문 · 목적 · 근거 필요 항목
02조사 분기일반 · 부동산 · 법령 중 필요한 도구 선택
03원고 승인브리프와 검증 원고를 확인하고 수정
04이미지 3장표지 1장 + 핵심 H2 두 장만 생성
18 / 19
THE OPERATING MODEL
좋은 자동화는
한 번에 완성하는 것이 아니라
검증하며 이어가는 것입니다.
한 번에 완성하는 것이 아니라
검증하며 이어가는 것입니다.
출처, 원고, 이미지 중 멈춘 단계만 다시 실행합니다.
브리프와 원고를 승인하고, 공개 여부를 최종 결정합니다.
19 / 19